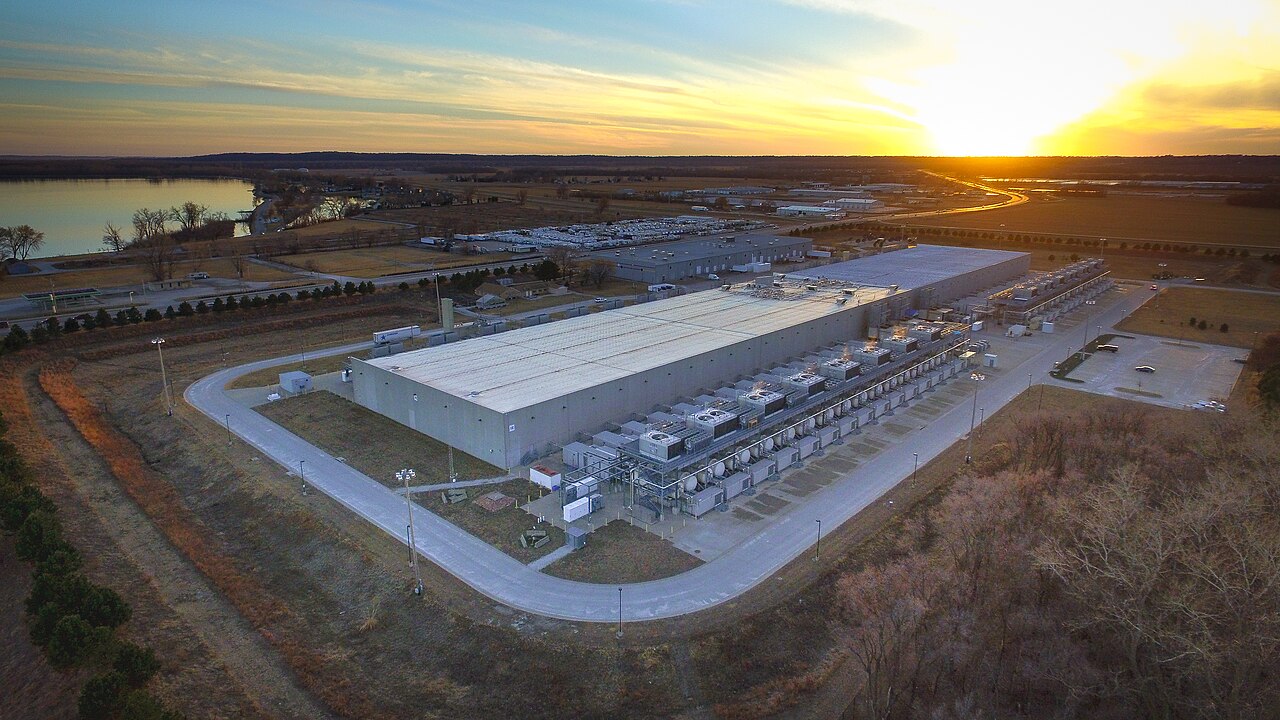
Rund acht Stunden lang war Googles Londoner Cloud-Zone am Dienstag nicht voll erreichbar. Ab 06:08 Uhr UTC - kurz nach 8 Uhr deutscher Zeit - meldete die Google-Statusseite „vermehrt Fehler und zeitweise Netzwerkausfälle“ in der Region europe-west2. Betroffen war speziell die Verfügbarkeitszone europe-west2-b, eine von drei im Londoner Rechenzentrum. Erst am Nachmittag galt der Vorfall als weitgehend behoben, einzelne Dienste benötigten noch länger.
Dass eine einzelne Zone einen so breiten Schaden anrichtete, lag an der Liste der betroffenen Produkte. Google selbst zählte mehrere Dutzend Services auf, darunter Apigee, den BigQuery Data Transfer Service, Cloud Filestore, Cloud Run, Datastream, die App Engine, die Kubernetes Engine, den NetApp-Volumes-Dienst sowie den Managed Service for Apache Kafka. Auch Google SecOps, das SIEM- und SOAR-Produkt für Sicherheitsteams, war bis in den Nachmittag hinein gestört, wie Heise berichtete.
Spürbar wurde das vor allem bei Kunden britischer Banken: Lloyds, HSBC, Bank of Scotland und Halifax konnten zeitweise keine Kontostände oder Überweisungen anzeigen. Die Neobank Revolut, die Teile ihrer Infrastruktur in europe-west2 betreibt, meldete Probleme beim Login, bei Kartenzahlungen und bei Bargeldauszahlungen; betroffen waren laut inside-it.ch allein in der Schweiz rund 1,3 Millionen Nutzer. Hinzu kamen Royal Mail, der Paketdienst DPD, British Telecom, das Immobilienportal Rightmove und der Baumarkt Screwfix. Eine zeitgleiche Störung bei ING war Google zufolge nicht mit dem Ausfall verknüpft.
Due to a power event we had suffered an outage within europe-west2-b zone.
Was Google sagt und was offen bleibt
Google selbst nannte den Grund früh: ein „Stromereignis“ in der Zone europe-west2-b. Als Behelf empfahl das Unternehmen, Workloads nach Möglichkeit in eine andere Zone oder Region zu verlagern. Mehr Details hat Google bislang nicht geliefert; ein ausführlicher Post-Mortem-Bericht steht noch aus. Zwei Tage nach dem Vorfall ist damit vor allem die Frage offen, warum sich die Störung nicht sauber auf die betroffene Zone eingrenzen ließ. Fachpublikationen wie IT Pro verweisen auf regionale Routing-Effekte, die über europe-west2-b hinaus wirkten; die technische Aufarbeitung dazu hat das Unternehmen auf seiner Dienst-Statusseite angekündigt.
Für die betroffenen Firmen ist der Zwischenfall vor allem ein Lehrstück zur Cloud-Konzentration. In Großbritannien belebt der Ausfall die Debatte darüber neu, wie stark Zahlungsverkehr, Logistik und öffentliche Dienste von einer Handvoll Hyperscaler abhängen; Fachmedien wie Financex berichten, dass die Finanzaufsicht die Vorfalldaten in laufende Prüfungen zur operativen Resilienz einbezieht. Deutsche Behörden wie BaFin oder Bundesnetzagentur äußerten sich zunächst nicht; sichtbare Auswirkungen auf große deutsche Dienstleister blieben am Dienstag aus.
#hugops im Fediverse
Parallel wurde der Ausfall in den sozialen Netzwerken zum Dauerthema. Das Kürzel #hugops, üblicherweise ein Zeichen der Solidarität mit Betriebsteams in akuten Störungslagen, gehörte am Dienstag und Mittwoch zu den meistgenutzten Tags im deutschsprachigen Fediverse - deutlich sichtbar auch in der Trendsammlung der Mastodon-Instanzen aus dem DACH-Raum. Wann Google den vollständigen Fehlerbericht nachliefert, ist bislang offen.